Các nhà khoa học 3 quốc gia tìm cách giúp AI tìm kiếm và kiểm chứng thông tin hiệu quả hơn
Sáng 7/9, sau phiên khai mạc và phiên toàn thể đầu tiên, Hội nghị APWeb-WAIM 2026 bước vào 24 phiên thảo luận song song. Trong đó có 3 nghiên cứu cùng tiếp cận bài toán làm sao để hệ thống AI tìm kiếm, lựa chọn, sử dụng và kiểm chứng thông tin hiệu quả dù chạy trong mô hình dữ liệu lớn.
Huấn luyện AI tìm đúng dữ liệu
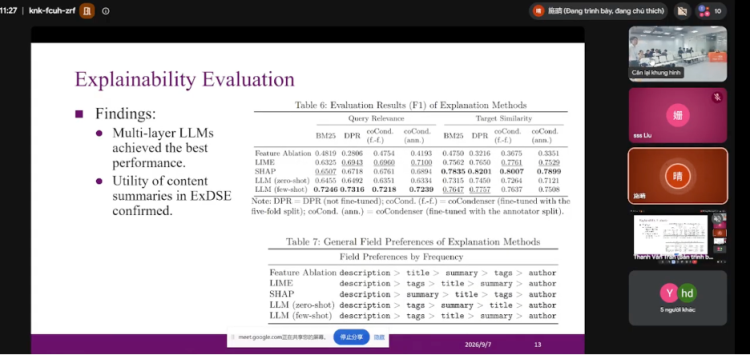
Mỗi ngày, Web có thêm vô số bộ dữ liệu mở với nhiều định dạng khác nhau. Với người dùng, việc tìm ra đúng bộ dữ liệu mình cần giữa kho thông tin khổng lồ này ngày càng trở nên khó khăn và đó cũng là bài toán mà các nhà nghiên cứu Qing Shi, Jing He, Qiaosheng Chen, Kongfa Hu, Gong Cheng tập trung giải quyết.
“DSEBench: A Test Collection for Explainable Dataset Search with Examples” xây dựng DSEBench - bộ dữ liệu đánh giá dành cho bài toán tìm kiếm dữ liệu dựa trên ví dụ và tìm kiếm có khả năng giải thích. Bộ dữ liệu được chú thích ở cả cấp độ toàn bộ tập dữ liệu và từng trường dữ liệu, đồng thời sử dụng mô hình ngôn ngữ lớn để tạo thêm dữ liệu phục vụ huấn luyện.
Phương pháp này cho phép hệ thống trả về một bộ dữ liệu phù hợp, đồng thời chỉ ra những trường dữ liệu cụ thể có liên quan đến nhu cầu tìm kiếm. Nói cách khác, mục tiêu không chỉ giúp AI “tìm thấy dữ liệu” mà còn tiến tới việc hiểu dữ liệu nào thực sự phù hợp và giải thích được lý do.
AI cần phải biết tự kiểm chứng thông tin
Từ bài toán tìm kiếm, các nhà nghiên cứu đến từ ĐH Điện tử Hàng Châu và Viện Y học Hàng Châu thuộc Viện Hàn lâm Khoa học Trung Quốc đặt vấn đề làm sao để hạn chế việc AI đưa ra thông tin không chính xác khi phải trả lời các câu hỏi phức tạp.
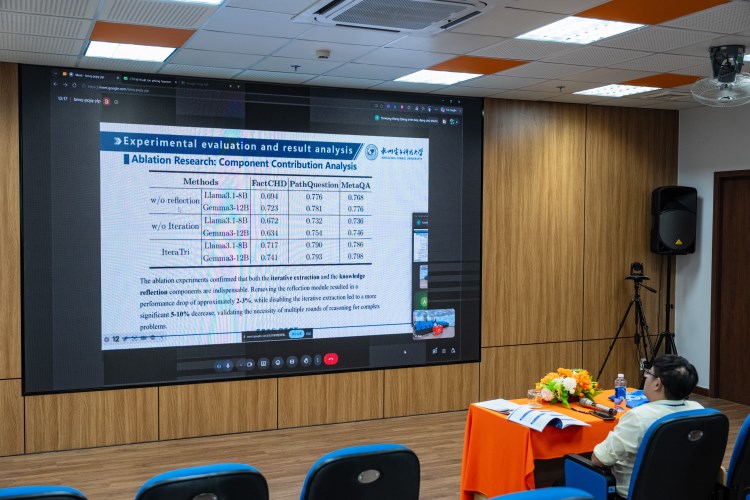
Nghiên cứu “IteraTri: Detecting Hallucination of LLM in Knowledge-Intensive QA via Iterative Verification” tập trung vào hiện tượng “ảo giác” của mô hình ngôn ngữ lớn - khi AI tạo ra câu trả lời nghe có vẻ hợp lý nhưng không dựa trên sự thật có thể kiểm chứng. IteraTri chia câu hỏi phức tạp thành những mối quan hệ thông tin cụ thể, sau đó lần lượt tìm kiếm và kiểm tra các thông tin này bằng đồ thị tri thức - một dạng hệ thống dữ liệu mô tả các thực thể và mối quan hệ giữa chúng.
Phải dùng AI quy mô lớn mới có thể suy luận tốt?
Cũng hướng tới việc nâng cao chất lượng suy luận của AI, nghiên cứu “AORS: Atomic Operator Driven Structured Reasoning Framework with Dual-Level Retrieval” đến từ các nhà khoa học từ ĐH Khoa học và Công nghệ Trường Sa và ĐH Công nghệ Quốc phòng Trung Quốc đã giải bài toán làm thế nào để các mô hình AI quy mô nhỏ có thể xử lý những câu hỏi phức tạp cần suy luận qua nhiều bước.
Theo đó, AORS giúp AI chuyển một câu hỏi phức tạp thành các bước suy luận nhỏ và có thể thực hiện, đồng thời tìm kiếm thông tin, bổ sung dữ liệu từ đồ thị tri thức và kiểm tra kết quả nhiều vòng. Tức là thay vì giải quyết bài toán bằng cách tăng kích thước mô hình, nghiên cứu tập trung cải thiện cách AI lập kế hoạch, tìm kiếm và kiểm chứng thông tin.
Thông qua thử nghiệm, nhóm tác giả Jingyu Zhang, Wenheng Li, Liqiang Xie, Zhijie Zhu, Qianzhen Zhang nhận thấy AORS giúp các mô hình quy mô nhỏ đạt độ ổn định và chính xác cao hơn trong bài toán hỏi đáp đa bước, giảm sự phụ thuộc vào những mô hình có số lượng tham số rất lớn.
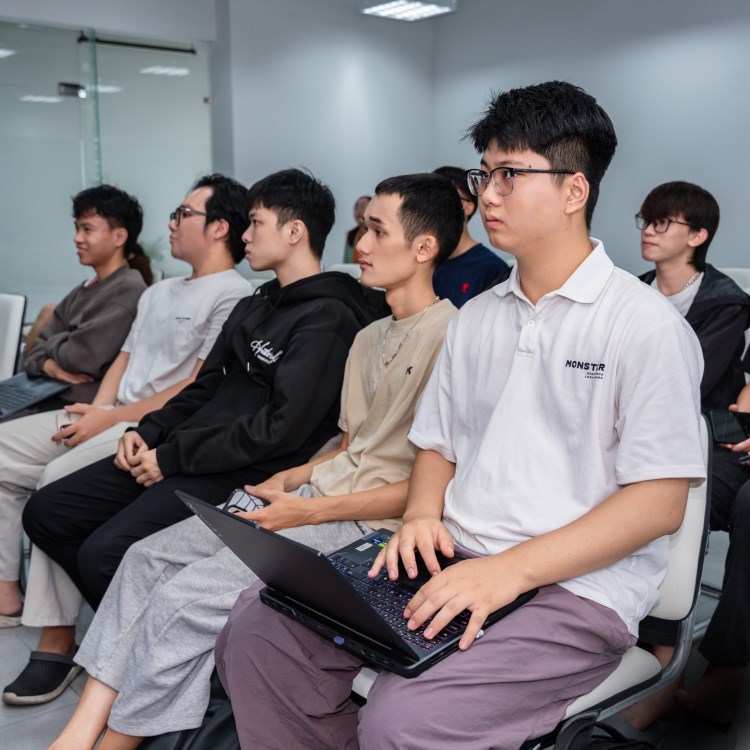
3 nghiên cứu, 3 bài toán khác nhau nhưng cùng cho thấy xu hướng chung trong nghiên cứu AI hiện nay. Năng lực của AI không chỉ đến từ việc tăng kích thước mô hình, quan trọng hơn là AI cần tìm đúng dữ liệu, sử dụng nguồn thông tin phù hợp với ngữ cảnh, bảo vệ dữ liệu người dùng và có khả năng kiểm chứng trước khi đưa ra kết luận.
Có thể thấy rằng, các nhà khoa học tại Hội nghị APWeb-WAIM năm nay dù tiếp cận những bài toán khác nhau nhưng cùng hướng tới mục tiêu xây dựng các hệ thống AI thông minh hơn trong xử lý dữ liệu, hiệu quả hơn trong suy luận và đáng tin cậy hơn khi tương tác với con người.
APWeb-WAIM 2026 có sự tham gia của ba diễn giả chính uy tín đến từ các trường đại học hàng đầu Singapore, Hong Kong, Trung Quốc, hơn 100 nhà nghiên cứu, chuyên gia, giảng viên và sinh viên đến từ 12 quốc gia và vùng lãnh thổ. Hội nghị quy tụ 162 công trình nghiên cứu trải rộng trên nhiều chủ đề như hệ thống Web, khai phá dữ liệu Web, cơ sở dữ liệu, Big Data, truy hồi thông tin, trí tuệ nhân tạo, học máy và điện toán đám mây. Các nghiên cứu được trình bày theo hình thức trực tuyến và trực tiếp.
Hội nghị APWeb-WAIM 2026 diễn ra từ ngày 7/9 - 9/9 tại Trường ĐH FPT phân hiệu Đà Nẵng.
Huệ Anh