Hội nghị APWeb-WAIM 2026: Làm thế nào để AI khai thác đúng thông tin giữa hàng tỷ dữ liệu?
Chia sẻ nghiên cứu tại Hội nghị APWeb-WAIM 2026 ngày 08/9 với chủ đề “Advanced Similarity Query Processing in Vector Databases”, Giáo sư Xiaofang Zhou (ĐH Khoa học và Công nghệ Hong Kong) đã giới thiệu phương pháp biểu diễn dữ liệu, các thuật toán lập chỉ mục và khả năng tìm kiếm trong cơ sở dữ liệu vectơ, đồng thời phân tích những ứng dụng của chúng trong các hệ thống AI hiện đại.
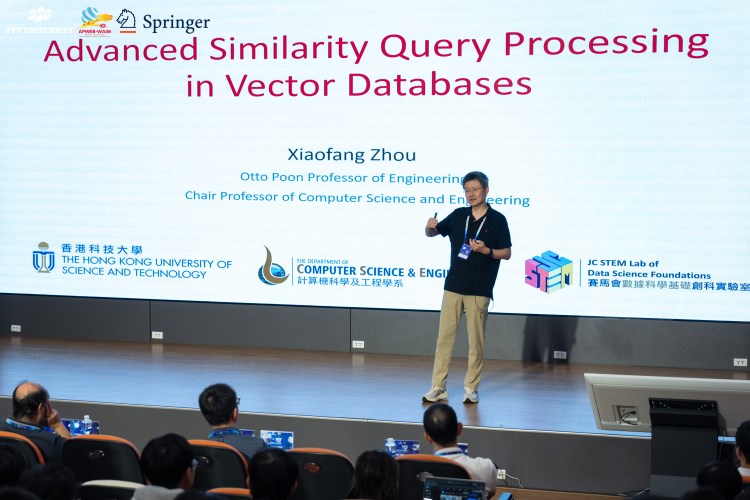
AI đang phát triển với tốc độ chưa từng có, kéo theo nhu cầu xử lý khối lượng dữ liệu ngày càng lớn. Khi các mô hình ngôn ngữ lớn (LLM), hệ thống RAG hay các tác nhân AI ngày càng được ứng dụng rộng rãi, một câu hỏi quan trọng đặt ra là: Làm thế nào để AI có thể nhanh chóng tìm kiếm và khai thác đúng thông tin giữa hàng tỷ dữ liệu? Theo Giáo sư Xiaofang Zhou, Đại học Khoa học và Công nghệ Hong Kong, một phần lời giải nằm ở vector database - cơ sở dữ liệu vector.
Trong cơ sở dữ liệu truyền thống, thông tin thường được tổ chức thành các bảng, dòng và cột. Tuy nhiên, dữ liệu mà AI hiện đại xử lý ngày càng đa dạng, từ văn bản, hình ảnh đến âm thanh và nhiều dạng dữ liệu phi cấu trúc khác.
Để máy tính xử lý những dữ liệu này, chúng có thể được chuyển thành vector embedding - những dãy số đại diện cho đặc điểm và ý nghĩa của dữ liệu. Có thể hình dung mỗi vector như một “điểm” trong một không gian nhiều chiều. Những dữ liệu có ý nghĩa tương đồng sẽ có xu hướng nằm gần nhau trong không gian này.
Chẳng hạn, khi tìm kiếm hình ảnh, thay vì chỉ so sánh tên tệp hoặc từ khóa, hệ thống có thể chuyển hình ảnh thành vector và tìm những vector nằm gần nó nhất. Cách tiếp cận này mở ra khả năng tìm kiếm dựa trên ý nghĩa và mức độ tương đồng, thay vì chỉ dựa trên từ khóa.
Đây cũng là lý do vector database ngày càng trở thành một thành phần quan trọng trong các hệ thống AI-native, đặc biệt khi được sử dụng cùng LLM và RAG.
Tuy nhiên, khi số lượng dữ liệu tăng từ hàng triệu lên hàng tỷ, việc tìm kiếm không còn đơn giản.
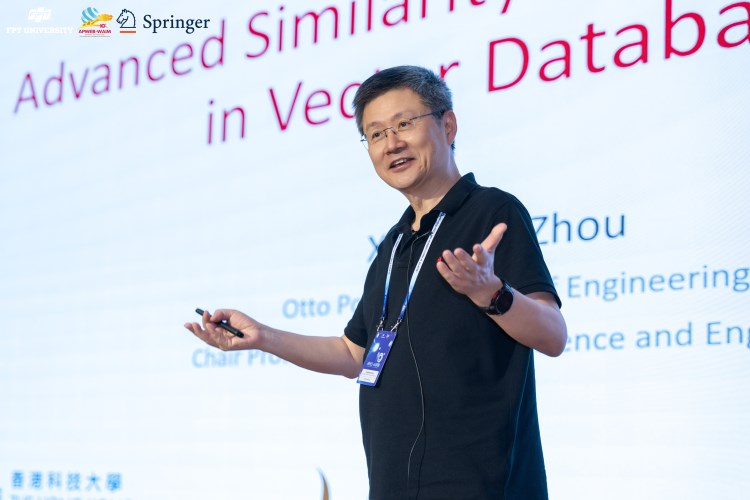
Nếu mỗi truy vấn đều phải lần lượt so sánh với hàng tỷ vector, hệ thống sẽ mất rất nhiều thời gian. Vì vậy, một trong những bài toán quan trọng mà Giáo sư Zhou tập trung nghiên cứu là similarity search – tìm kiếm dữ liệu tương đồng và cách xây dựng các cơ chế lập chỉ mục (indexing) để quá trình này diễn ra hiệu quả hơn. Một thách thức khác là curse of dimensionality – “lời nguyền số chiều”. Khi vector có số chiều rất lớn, khoảng cách giữa các điểm trong không gian trở nên khó phân biệt rõ ràng. Điều này khiến việc xác định đâu là dữ liệu thực sự gần với truy vấn trở nên phức tạp hơn.
Để giải quyết bài toán, nghiên cứu về vector database phát triển nhiều hướng tiếp cận. Một phương pháp là chia không gian vector thành các vùng hoặc “bucket”, từ đó thu hẹp phạm vi cần tìm kiếm. Một hướng khác là xây dựng graph-based index, trong đó các vector được kết nối với nhau dựa trên mức độ tương đồng. Khi có truy vấn, hệ thống có thể lần theo các kết nối này để nhanh chóng tiến đến những điểm gần nhất.
Bên cạnh đó, Giáo sư Zhou cũng đề cập đến quantization – lượng tử hóa, kỹ thuật giúp giảm lượng thông tin cần lưu trữ cho mỗi vector, qua đó tăng hiệu quả tìm kiếm. Tuy nhiên, tối ưu tốc độ và bộ nhớ luôn đi kèm bài toán cân bằng với độ chính xác.
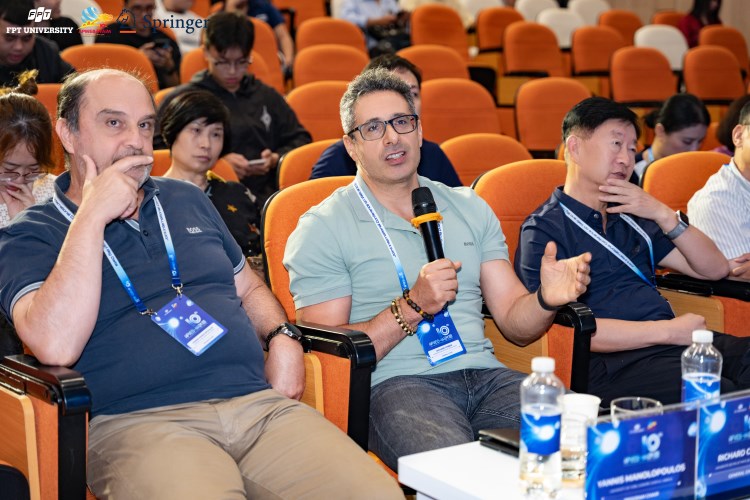
Theo Giáo sư Zhou, nghiên cứu về vector database không dừng lại ở việc làm cho một truy vấn nhanh hơn. Khi hệ thống AI ngày càng lớn, những vấn đề như cập nhật và xóa dữ liệu, tìm kiếm trong môi trường phân tán, kết hợp nhiều tập dữ liệu hay xử lý trên các thiết bị và môi trường tính toán khác nhau cũng trở nên quan trọng.
Đáng chú ý, nhóm nghiên cứu không chỉ tìm cách xây dựng những hệ thống mới mà còn đặt câu hỏi liệu các kỹ thuật từ cơ sở dữ liệu truyền thống có thể được mở rộng để phục vụ vector search hay không.
Từ góc nhìn này, vector database không đơn thuần là một công nghệ lưu trữ dữ liệu mới. Đây là một trong những lớp hạ tầng giúp AI có thể tiếp cận lượng thông tin ngày càng lớn, tìm kiếm dữ liệu liên quan và đưa những dữ liệu đó vào quá trình xử lý.
Khi AI chuyển từ việc “biết” sang khả năng tìm kiếm, kết nối và sử dụng dữ liệu đúng lúc, những bài toán phía sau cơ sở dữ liệu cũng trở thành một phần quan trọng của cuộc đua phát triển AI.
Hội nghị quốc tế 10th Asia Pacific Web and Web-Age Information Management Joint International Conference on Web and Big Data (APWeb-WAIM 2026) đang diễn ra tại Trường ĐH FPT phân hiệu Đà Nẵng, từ ngày 07-09/9/2026.
Hội nghị có sự tham gia của ba diễn giả chính uy tín đến từ các trường đại học hàng đầu Singapore, Hong Kong, Trung Quốc, hơn 100 nhà nghiên cứu, chuyên gia, giảng viên và sinh viên đến từ 12 quốc gia và vùng lãnh thổ. Hội nghị quy tụ 162 công trình nghiên cứu trải rộng trên nhiều chủ đề như hệ thống Web, khai phá dữ liệu Web, cơ sở dữ liệu, Big Data, truy hồi thông tin, trí tuệ nhân tạo, học máy và điện toán đám mây. Các nghiên cứu được trình bày theo hình thức trực tuyến và trực tiếp.
Thu Uyên - fpt.edu.vn