Các nghiên cứu phân tích sâu ứng dụng của AI vào thực tiễn quản lý thông tin tại APWeb-WAIM 2026
- Hội nghị APWeb-WAIM 2026: Điểm hẹn học thuật uy tín cho giới Web & Big Data
- APWeb-WAIM 2026 mở ra cơ hội hợp tác nghiên cứu cho cộng đồng học thuật Việt Nam
- Hội nghị APWeb-WAIM 2026: Làm thế nào để AI khai thác đúng thông tin giữa hàng tỷ dữ liệu?
- APWeb-WAIM 2026: Các nghiên cứu nâng cấp AI xử lý thông minh các dữ liệu phức tạp
- Hội nghị APWeb-WAIM 2026: AI đang thay đổi cơ sở dữ liệu như thế nào?
Các công trình nghiên cứu được trình bày trong ngày thứ 3 của hội nghị APWeb-WAIM cho thấy sự đa dạng của những bài toán AI đang được cộng đồng nghiên cứu quan tâm. Những nghiên cứu này cũng cho thấy AI đang được phát triển theo hướng ngày càng gắn với các nhu cầu cụ thể của thực tế.
AI từ “đọc được chữ” đến hiểu được cấu trúc của code
“Recognition of Handwritten Python Code in Academic Exam Settings Using a Multi-stage OCR Pipeline” là nghiên cứu về việc nhận diện code Python được sinh viên viết tay trên giấy thi của nhóm tác giả Minh Do, Cong Tam Phan, Hoang Phuc Mai, Ngoc Bao Quang Nguyen, Cao Vu Bui (Trường ĐH FPT).
Nghiên cứu xây dựng một quy trình OCR nhiều bước, kết hợp phát hiện dòng bằng YOLO, phân loại trạng thái của từng dòng, nhận diện chữ bằng TrOCR và xử lý riêng phần thụt lề để khôi phục cấu trúc code. Đây là bài toán khó hơn nhận diện chữ viết thông thường bởi chỉ một ký hiệu, dấu câu hoặc khoảng thụt lề sai cũng có thể khiến đoạn code không còn chính xác.
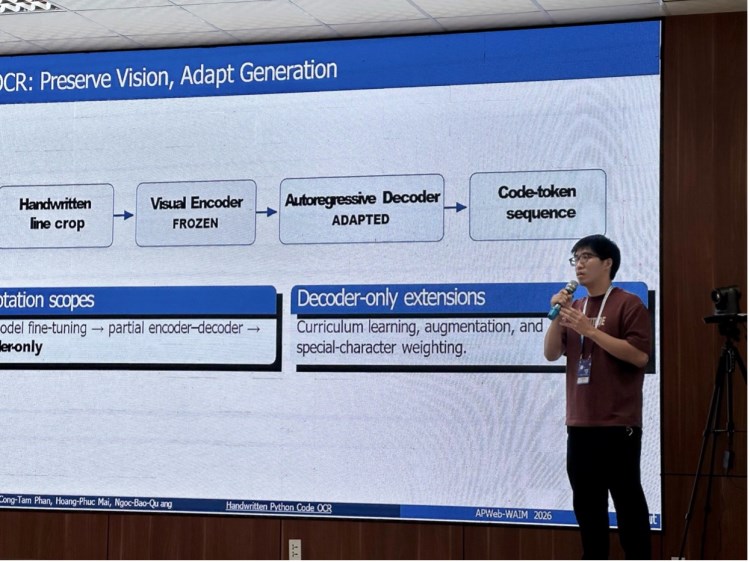
Trong quá trình thử nghiệm, nhóm cứu nhận thấy việc giữ lại phần biểu diễn hình ảnh đã được huấn luyện trước và chỉ điều chỉnh bộ giải mã giúp hệ thống ổn định hơn trong điều kiện dữ liệu hạn chế. Đồng thời, việc tăng trọng số cho các ký tự đặc biệt cũng giúp giảm lỗi ở những thành phần quan trọng đối với cú pháp.
Đáng chú ý, nghiên cứu không chỉ đánh giá khả năng “đọc” từng dòng mà xem xét toàn bộ quy trình từ phát hiện, lọc, nhận diện đến tái cấu trúc code, hướng tới câu hỏi quan trọng hơn là kết quả cuối cùng có thể sử dụng được hay không.
AI bảo vệ hệ thống mạng trước những “dấu vết giả”
Một nghiên cứu khác đến từ các nhà khoa học Việt Nam lại tập trung vào bài toán bảo vệ AI trước những dữ liệu được cố tình tạo ra để đánh lừa hệ thống. Nhóm tác giả Manh-Huy Dang, Xuan-Trang Phan-Thi, Thanh-Thao Truong, Hung-Chen Truong, Thanh-Nam Chan (Trường ĐH Nam Cần Thơ) đi tìm lời giải qua nghiên cứu “Graph Structure Purification: A Two-Stage Defense Against Structural Adversarial Attacks on GNN-Based Network Intrusion Detection Systems”.
Theo đó, AI thường phân tích mối liên hệ giữa nhiều thiết bị và hoạt động trên mạng để tìm ra dấu hiệu đáng ngờ. Tuy nhiên, kẻ tấn công có thể tạo thêm những kết nối giả trong dữ liệu nhằm đánh lạc hướng khiến AI không nhận ra đâu là hoạt động nguy hiểm. Từ đó, nhóm đề xuất sử dụng “bộ lọc” Graph Structure Purifier (GSP) giúp kiểm tra và loại bỏ những kết nối đáng ngờ trước khi dữ liệu được đưa vào mô hình AI.
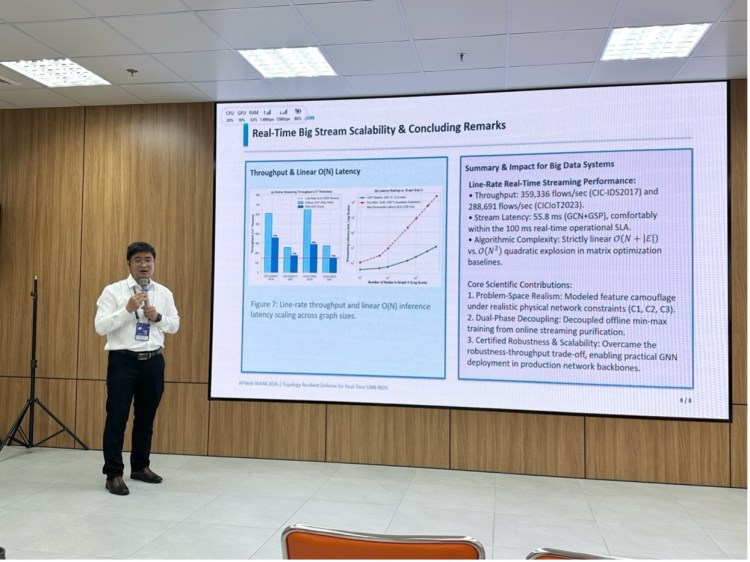
Thử nghiệm trên bộ dữ liệu CIC-IDS2017 cho thấy phương pháp này giúp cải thiện đáng kể khả năng phát hiện của mô hình. Trong một kịch bản bị tấn công, độ chính xác F1 của mô hình GCN tăng từ 4,2% lên 34,7%; đồng thời, các cấu hình thử nghiệm đều đạt tốc độ xử lý trên 150.000 luồng dữ liệu mỗi giây với độ trễ không quá 132 mili giây.
Có thể thấy rằng, “làm sạch” dữ liệu trước khi AI đưa ra quyết định có thể đóng vai trò quan trọng trong việc xây dựng các hệ thống phát hiện tấn công mạng vừa chính xác vừa có khả năng xử lý nhanh.
AI không nhất thiết phải xử lý mọi dữ liệu theo cùng một cách
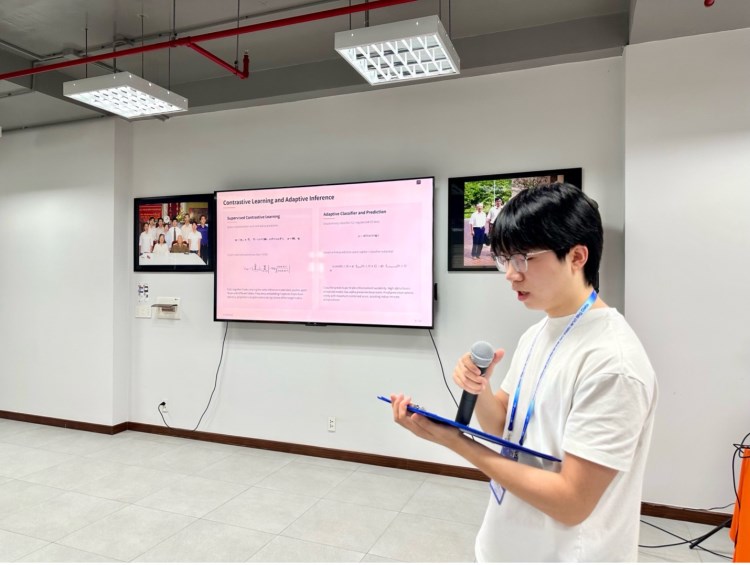
Nhóm tác giả Jingyu Zhang, Liqiang Xie, Zhijie Zhu, Wenheng Li, Qianzhen Zhang đến từ Phòng thí nghiệm trọng điểm Quốc gia về Kỹ thuật Hệ thống Thông tin (ĐH Công nghệ Quốc phòng) và Changsha University of Science and Technology (Trung Quốc) đã giới thiệu “CLEEF: A Contrastive Learning-Based Embedding Enhancement Framework with Triple-Level Adaptive Selection” - phương pháp giúp AI hiểu và xử lý thông tin trong đồ thị tri thức, một cách tổ chức dữ liệu bằng cách liên kết các sự vật, khái niệm và mối quan hệ giữa chúng.
Đại diện nhóm cho biết, thay vì áp dụng một cách suy luận cho tất cả dữ liệu, CLEEF giúp AI lựa chọn cách xử lý phù hợp với từng trường hợp. Để làm được điều này, phương pháp sẽ so sánh các cách biểu diễn thông tin khác nhau, sau đó sử dụng một bộ phân loại đơn giản để quyết định cách suy luận nào phù hợp hơn. Nhóm cũng bổ sung những dữ liệu được thiết kế để AI học cách phân biệt kết quả đúng và sai, đặc biệt trong trường hợp dữ liệu đúng và sai không được phân bố đồng đều.
Có thể thấy rằng, các nhà khoa học trong nước và quốc tế đều đang đẩy mạnh nghiên cứu AI theo hướng không chỉ làm tốt một tác vụ riêng lẻ mà phải biết xử lý đúng cách, đánh giá đúng kết quả và tạo ra đầu ra phù hợp với mục đích sử dụng.
Sự đa dạng này cũng phản ánh quy mô quốc tế của APWeb-WAIM 2026, nơi các nhóm nghiên cứu từ nhiều quốc gia cùng trao đổi về những bài toán từ nền tảng dữ liệu đến các ứng dụng AI cụ thể. Đặc biệt, sự hiện diện của các công trình từ Việt Nam, trong đó có nghiên cứu của Trường ĐH FPT cho thấy giới nghiên cứu trong nước đang ngày càng tham gia sâu hơn vào những hướng công nghệ mới cũng như kết nối nghiên cứu với đào tạo nguồn nhân lực cho các lĩnh vực chiến lược như AI, dữ liệu và chuyển đổi số.
Sau các phiên trình bày buổi sáng, APWeb-WAIM 2026 chính thức bế mạc vào 13h30 ngày 9/9, khép lại những trao đổi học thuật giữa cộng đồng nghiên cứu quốc tế tại Việt Nam tại sự kiện lần này.
Huệ Anh